GeminiDB

¿Por qué elegir GeminiDB de Huawei Cloud?

¿Por qué elegir GeminiDB de Huawei Cloud?

Escalabilidad

Arquitectura sin componentes compartidos y con almacenamiento compartido: Los nodos de cómputo sin estado comparten un motor de almacenamiento distribuido con estado.

Elevada utilización de recursos: Los clústeres de proxy integrados admiten el balanceo de carga de datos dinámico.

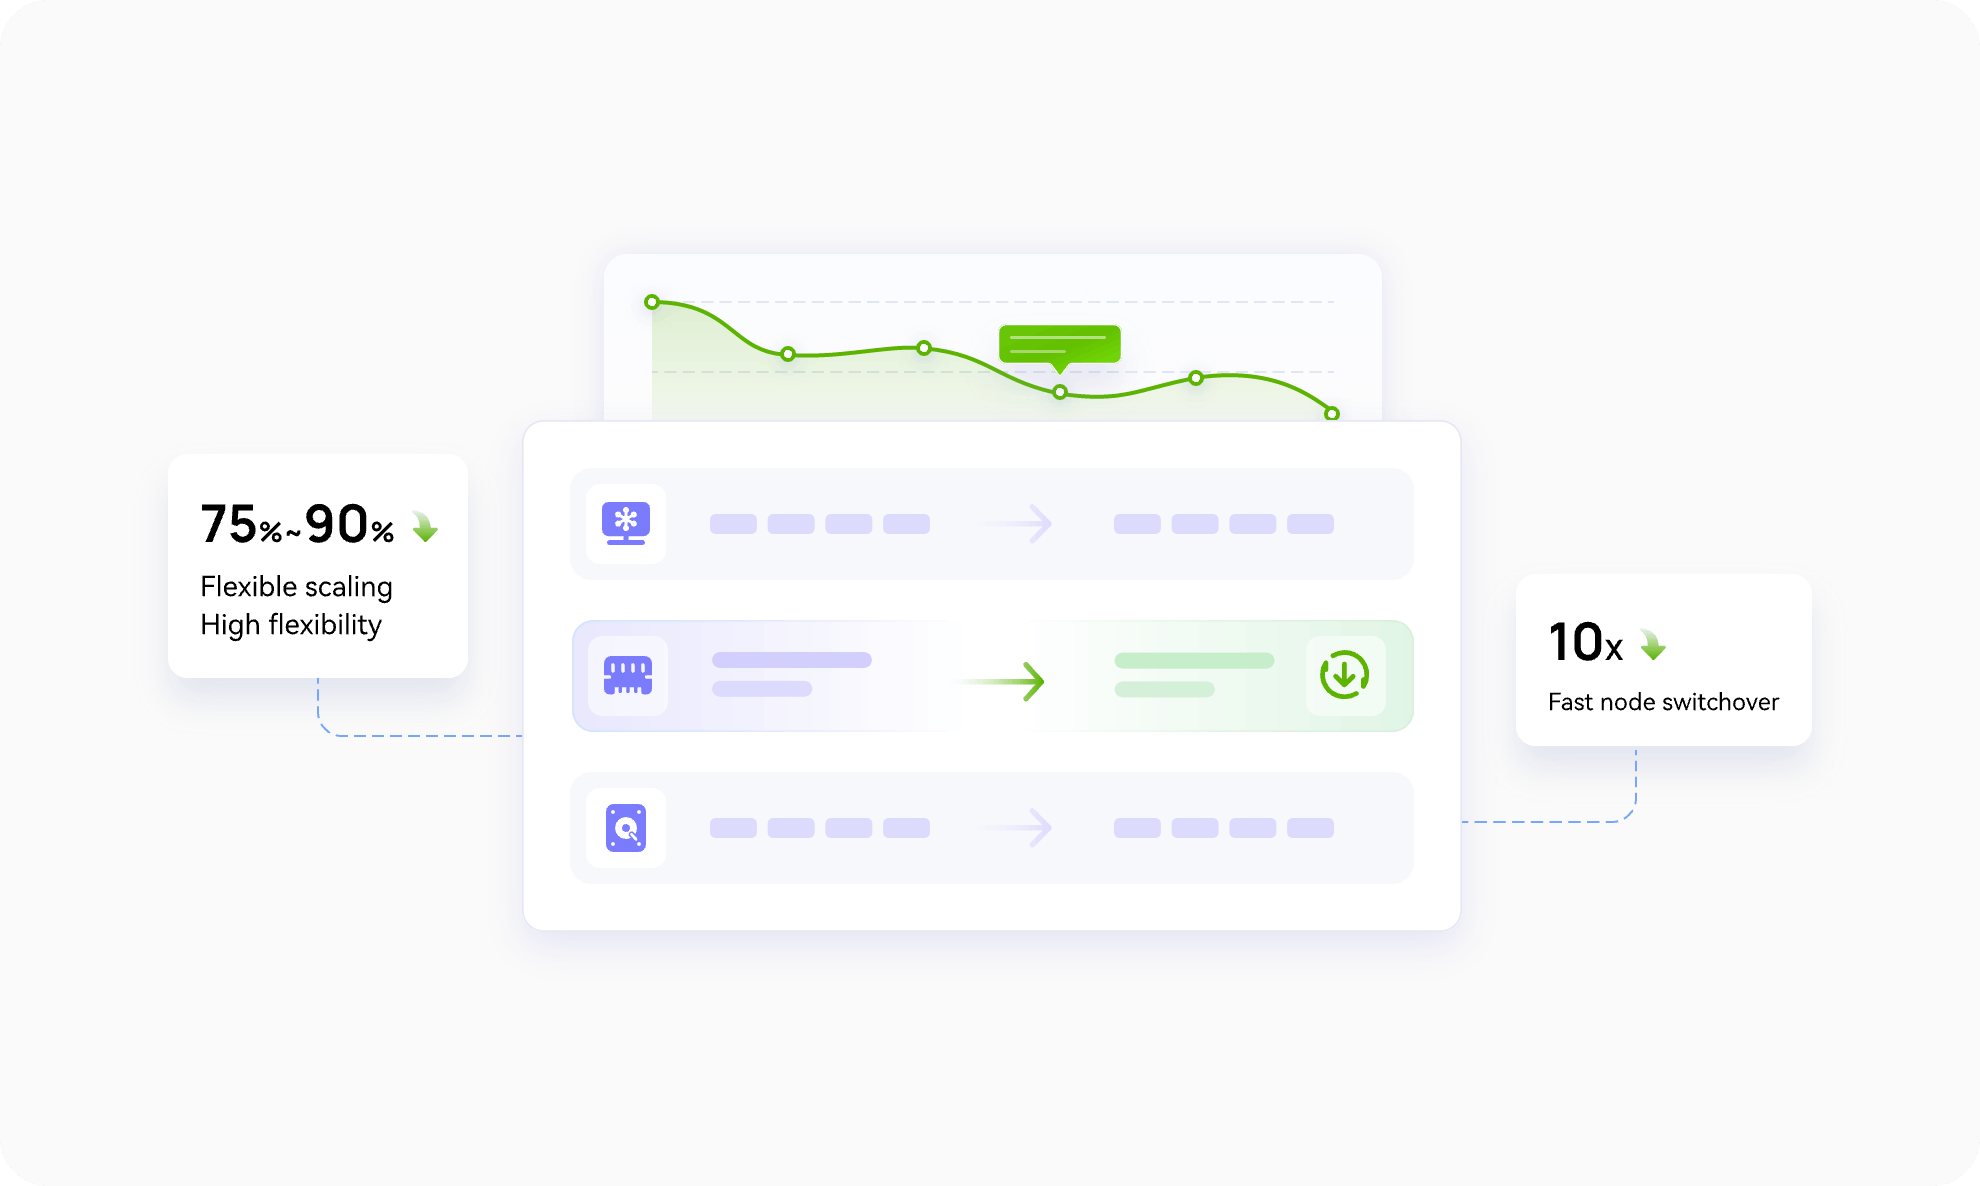
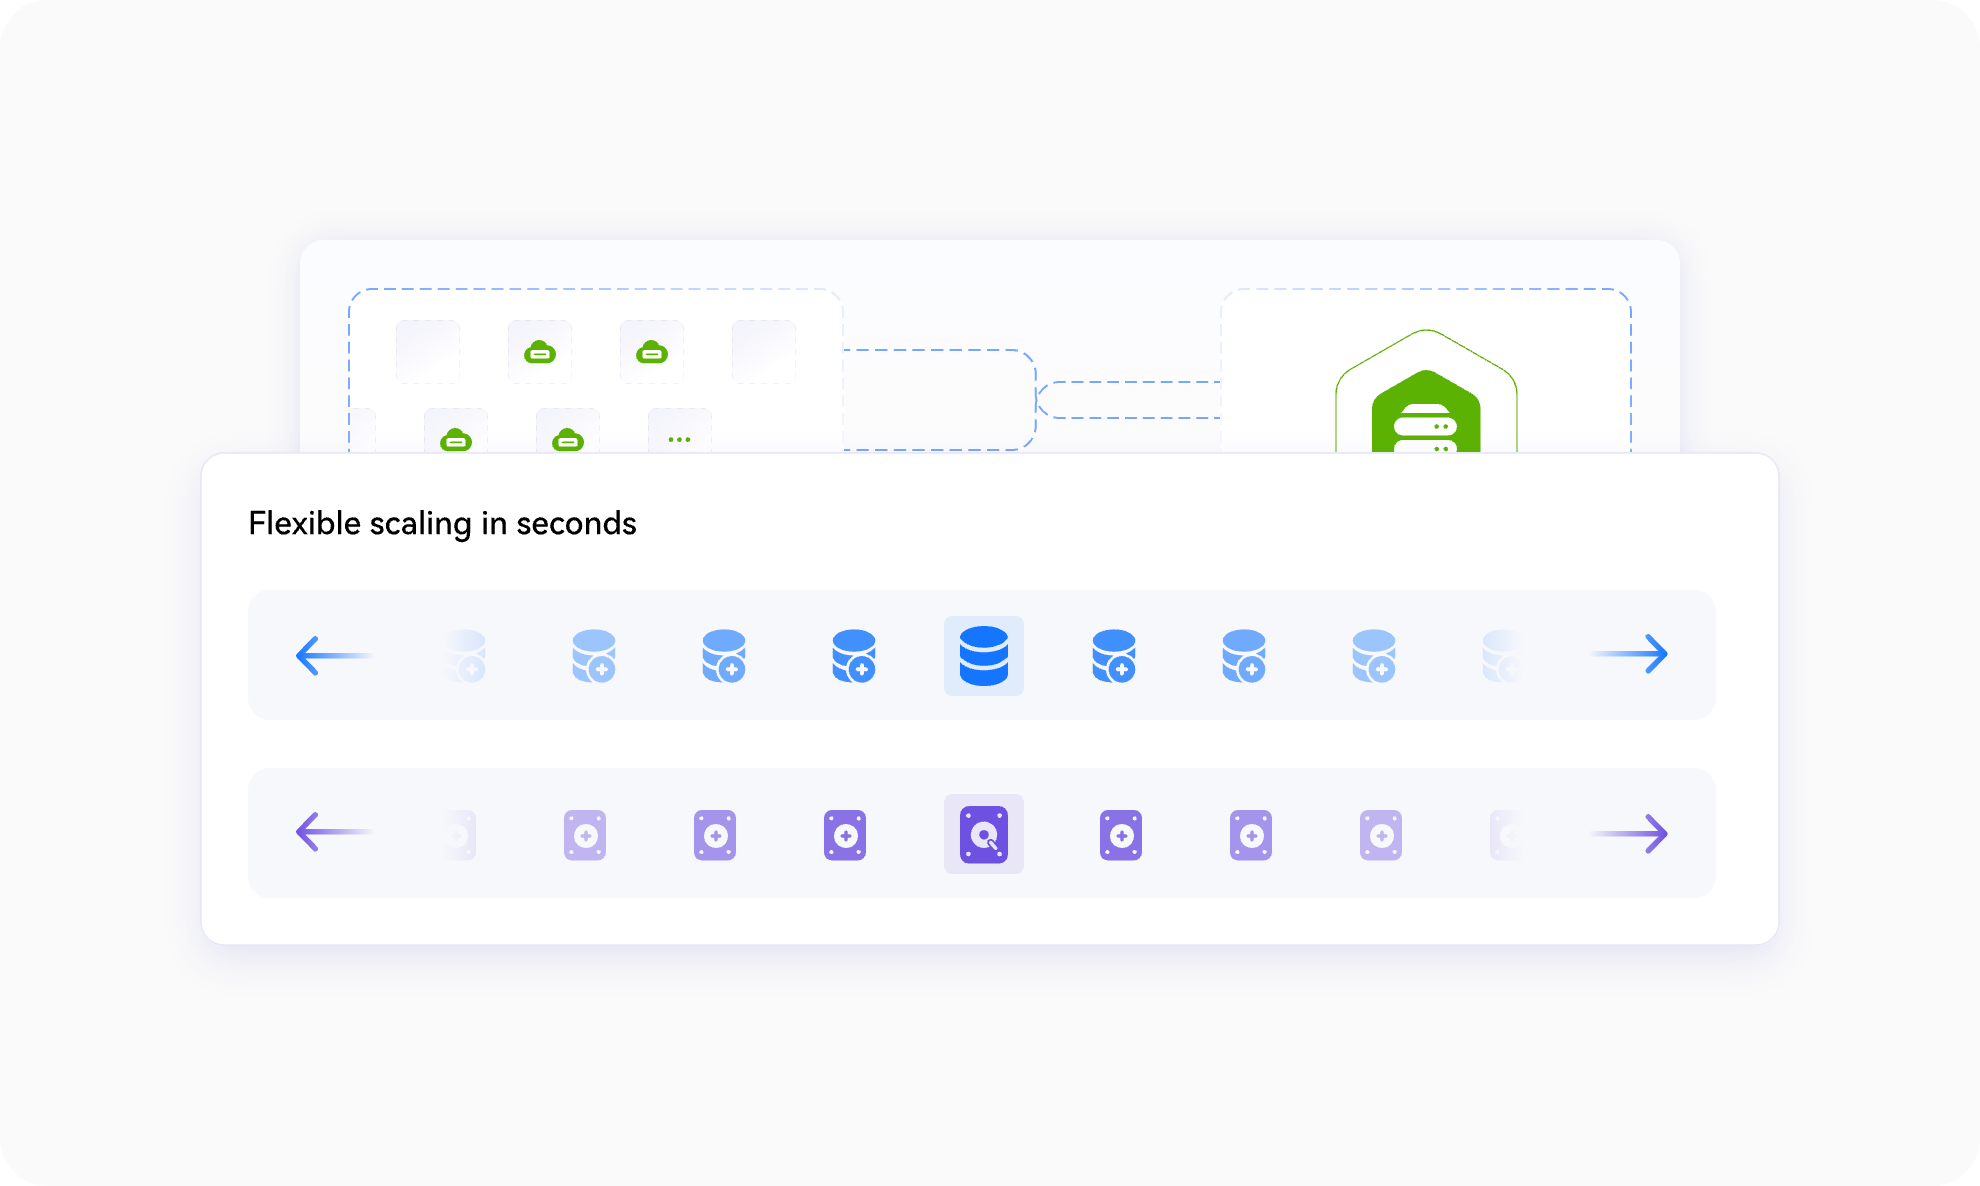
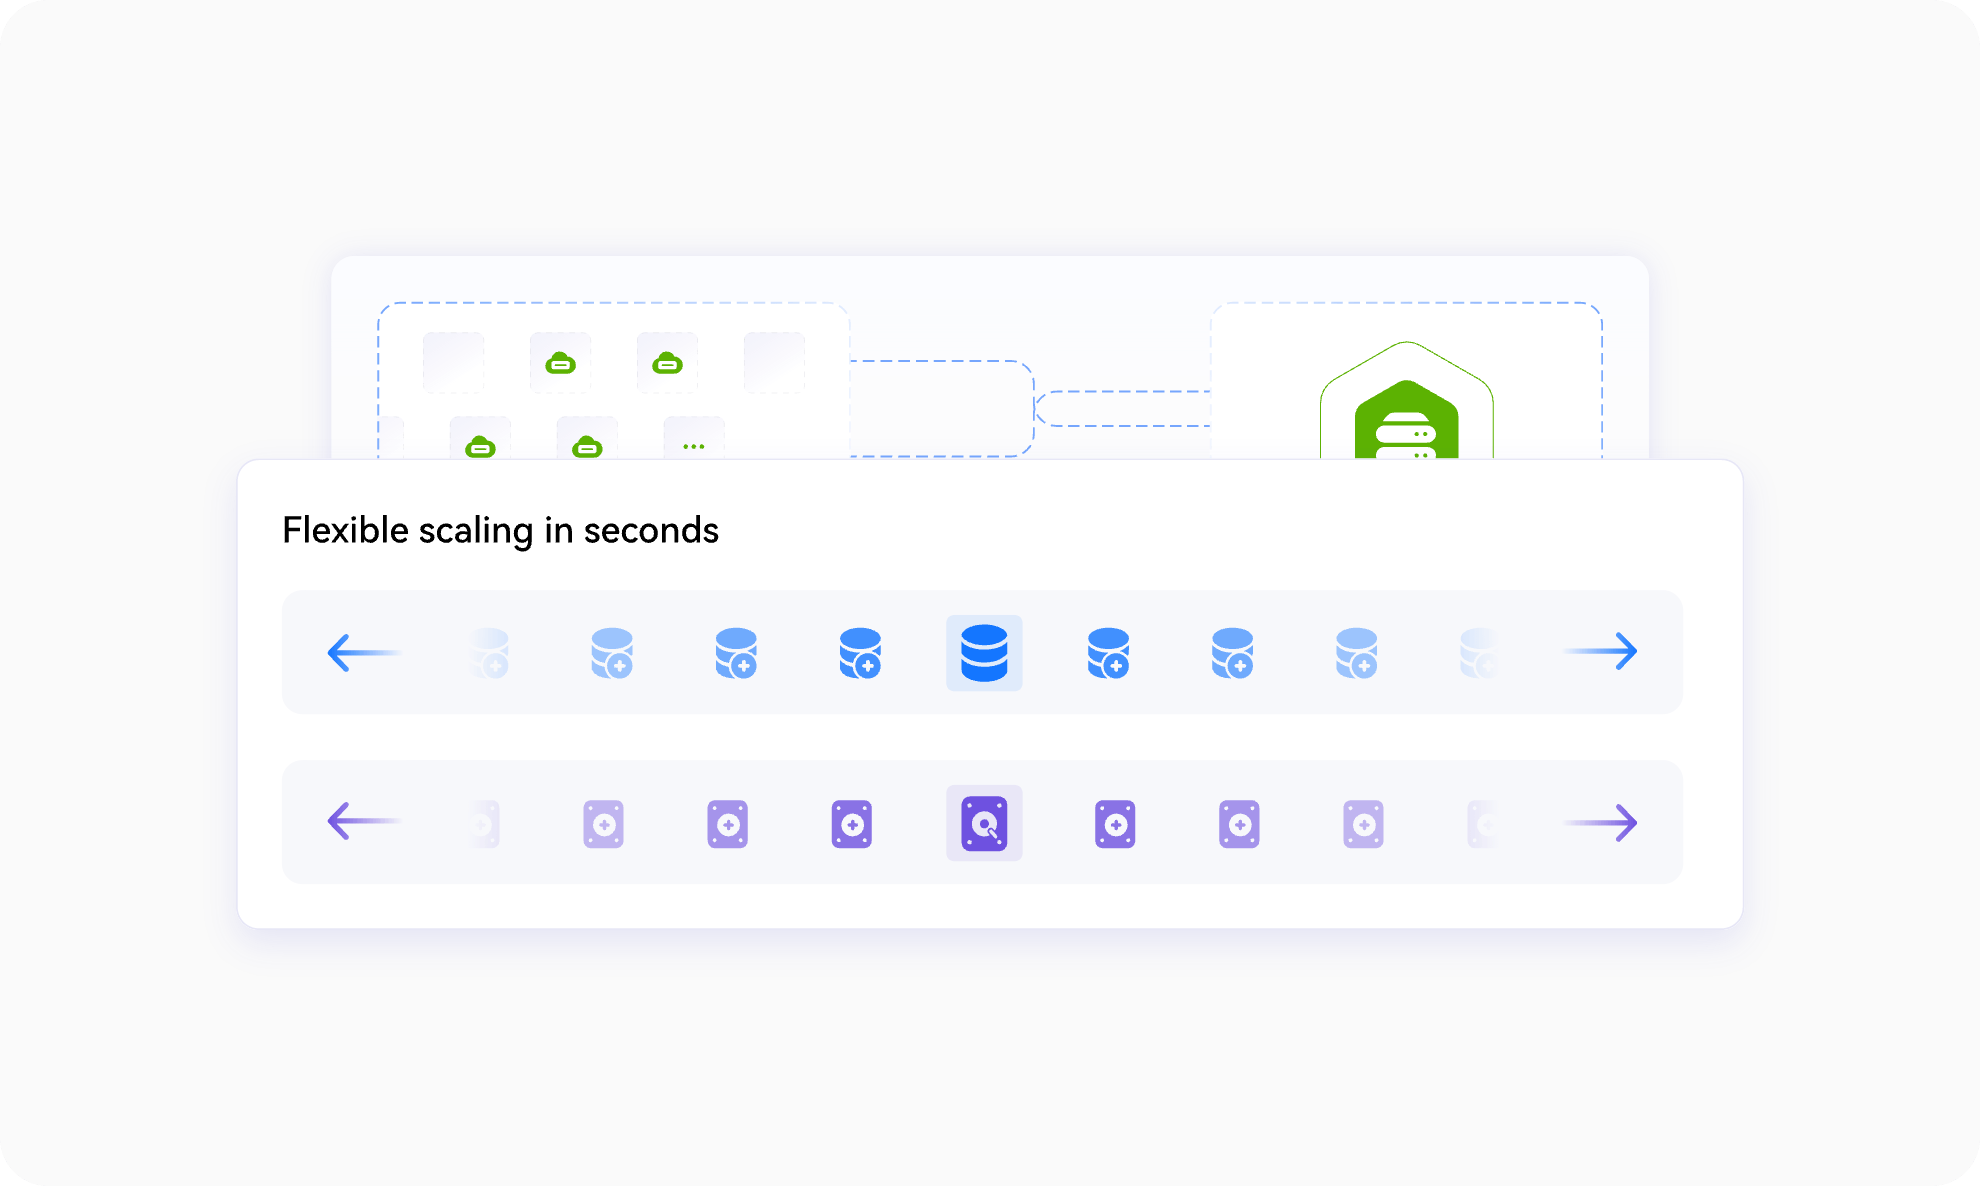
Escalamiento elástico: Los nodos de cómputo se pueden añadir en minutos y el almacenamiento se puede escalar verticalmente en segundos.
Escalabilidad

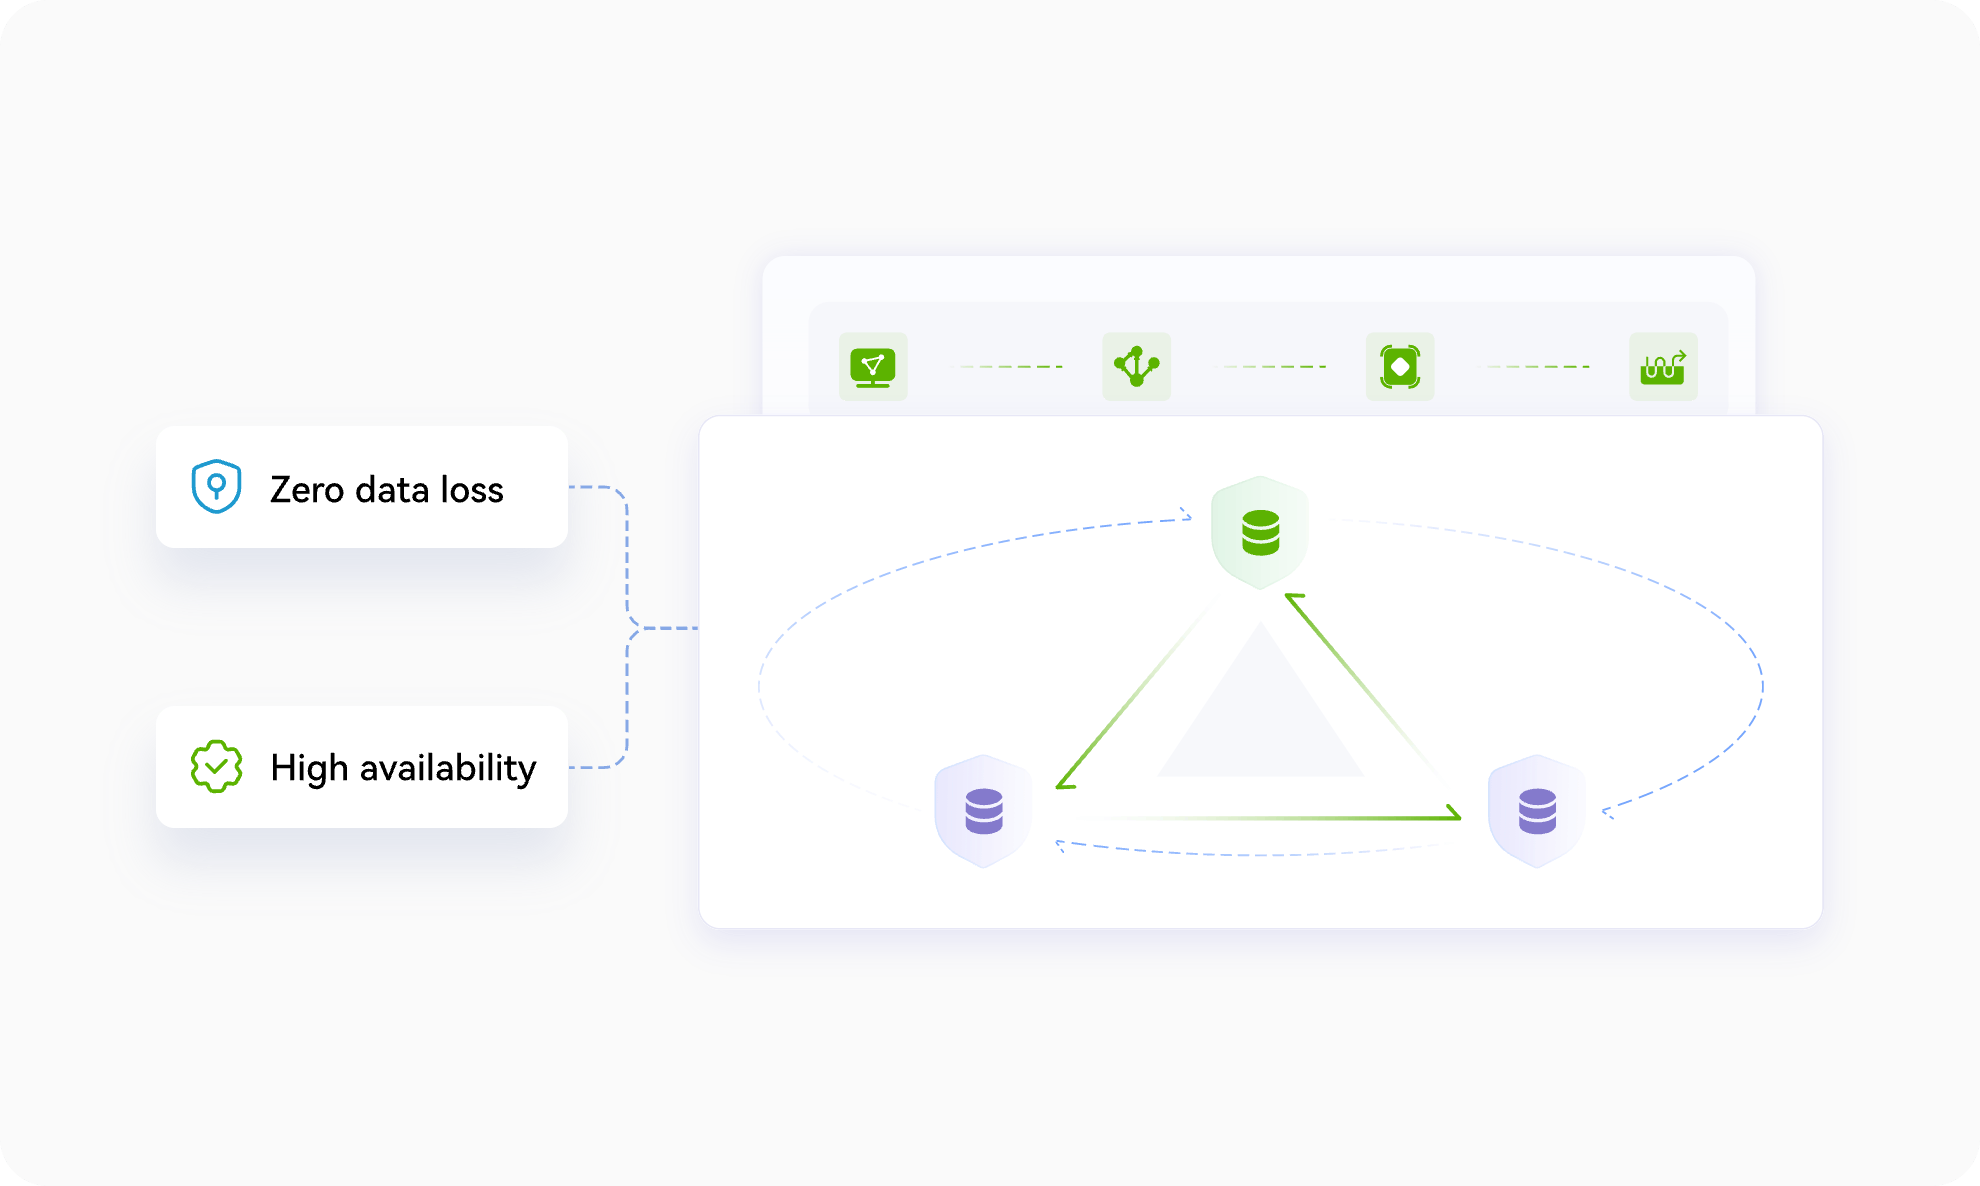
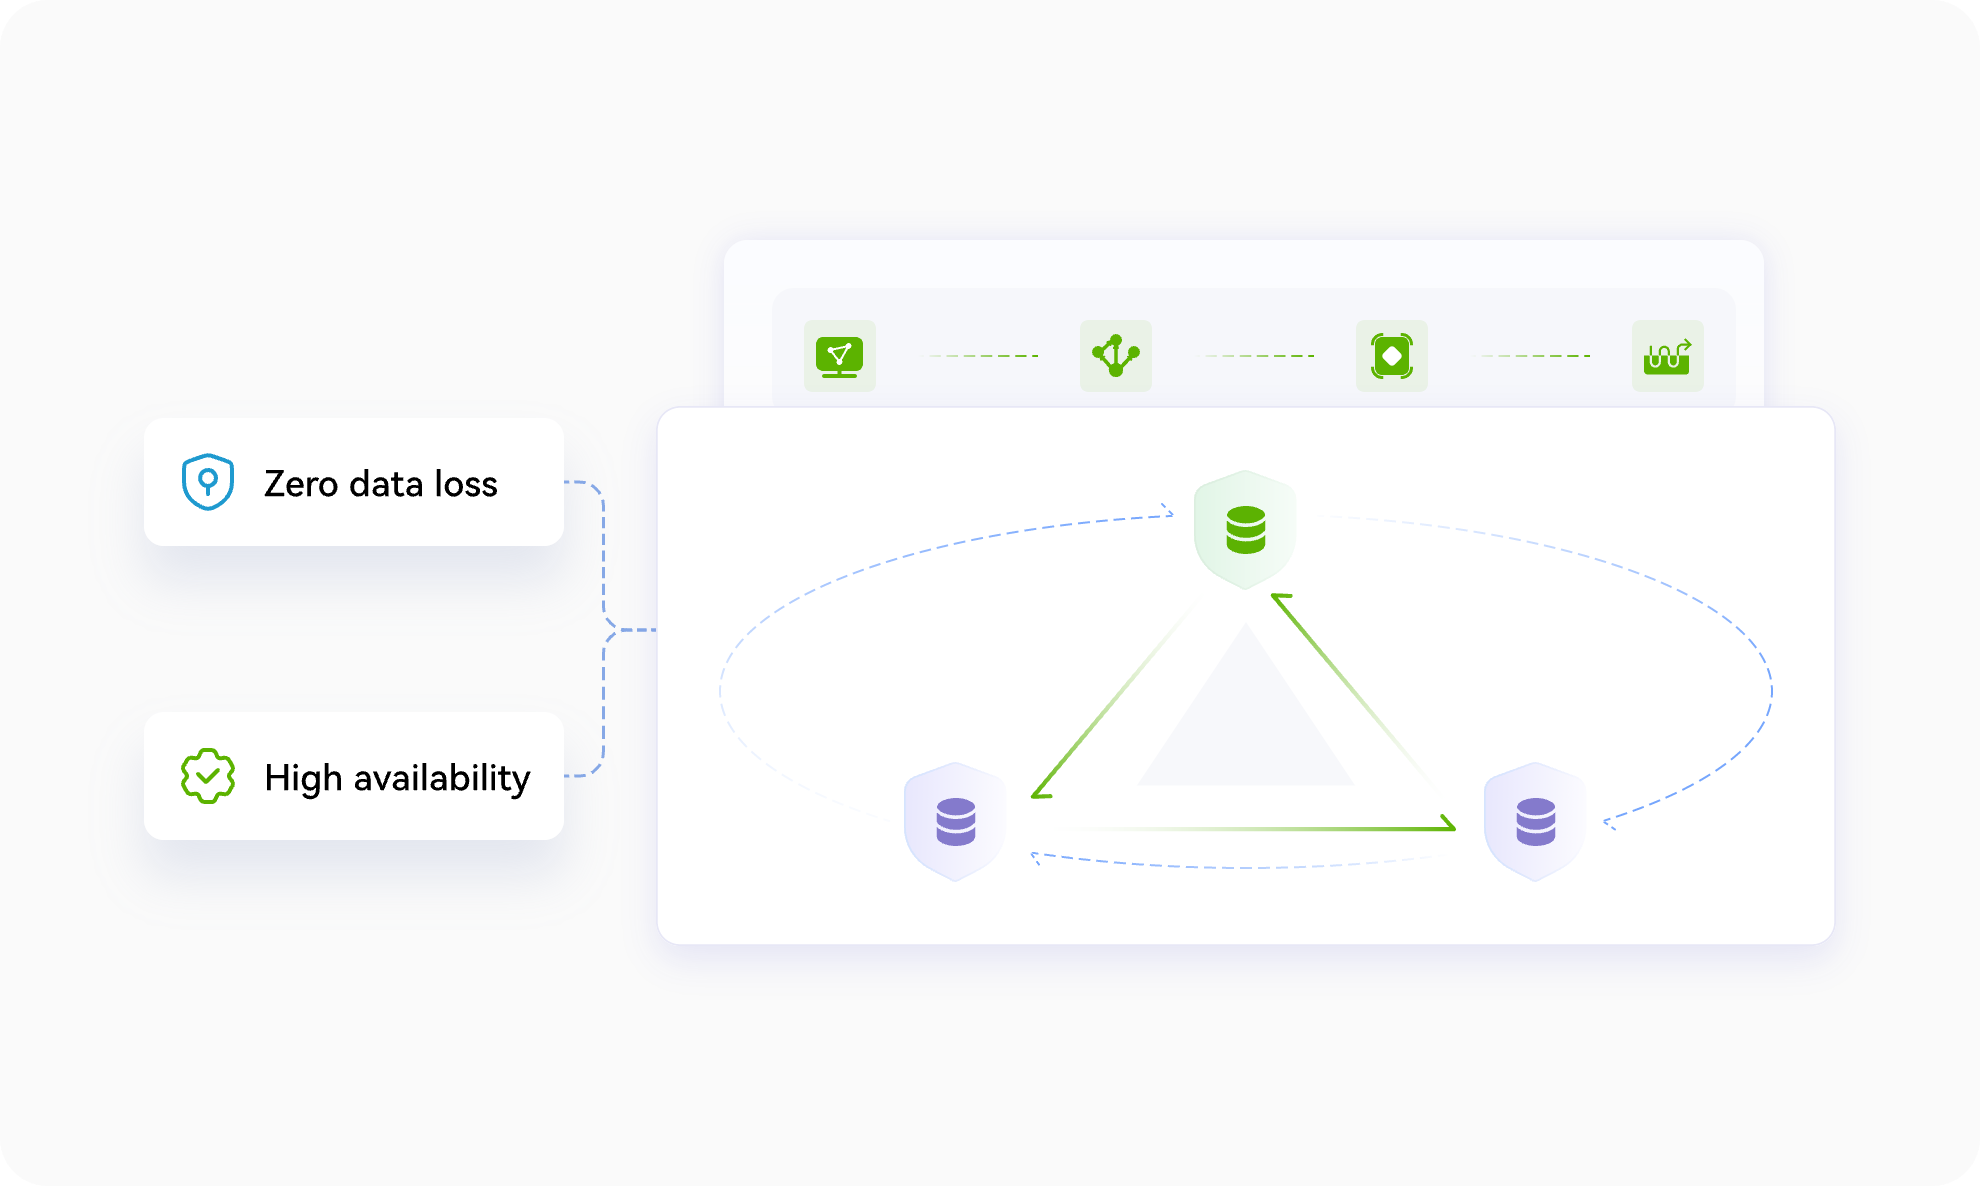
Cero pérdidas de datos y sólida coherencia de datos: Tres copias de datos se almacenan en un grupo de almacenamiento compartido distribuido, lo que garantiza que no se pierdan datos y una sólida coherencia para el acceso multipunto.

Alta disponibilidad: La conmutación automática por falla de los nodos se completa en segundos, lo que minimiza las interrupciones de servicio. La instancia permanece disponible incluso cuando fallan N-1 nodos simultáneamente.

Rendimiento estable: El diseño de GeminiDB contempla la estabilidad de extremo a extremo, con múltiples subprocesos distribuidos en la capa de cómputo y acceso directo a memoria remota (RDMA) en la capa de almacenamiento. El motor de almacenamiento RocksDB está optimizado y clasifica los datos según la frecuencia con la que se accede a ellos (poca o mucha), lo que acelera el acceso a los datos de mayor demanda.
Fiabilidad

Rendimiento de cómputo maximizado: Gracias al almacenamiento y el cómputo desacoplados de GeminiDB, todos los nodos de cómputo admiten tanto lecturas como escrituras, lo que reduce el desperdicio de recursos de los nodos en espera en los despliegues tradicionales y mejora la utilización del cómputo.

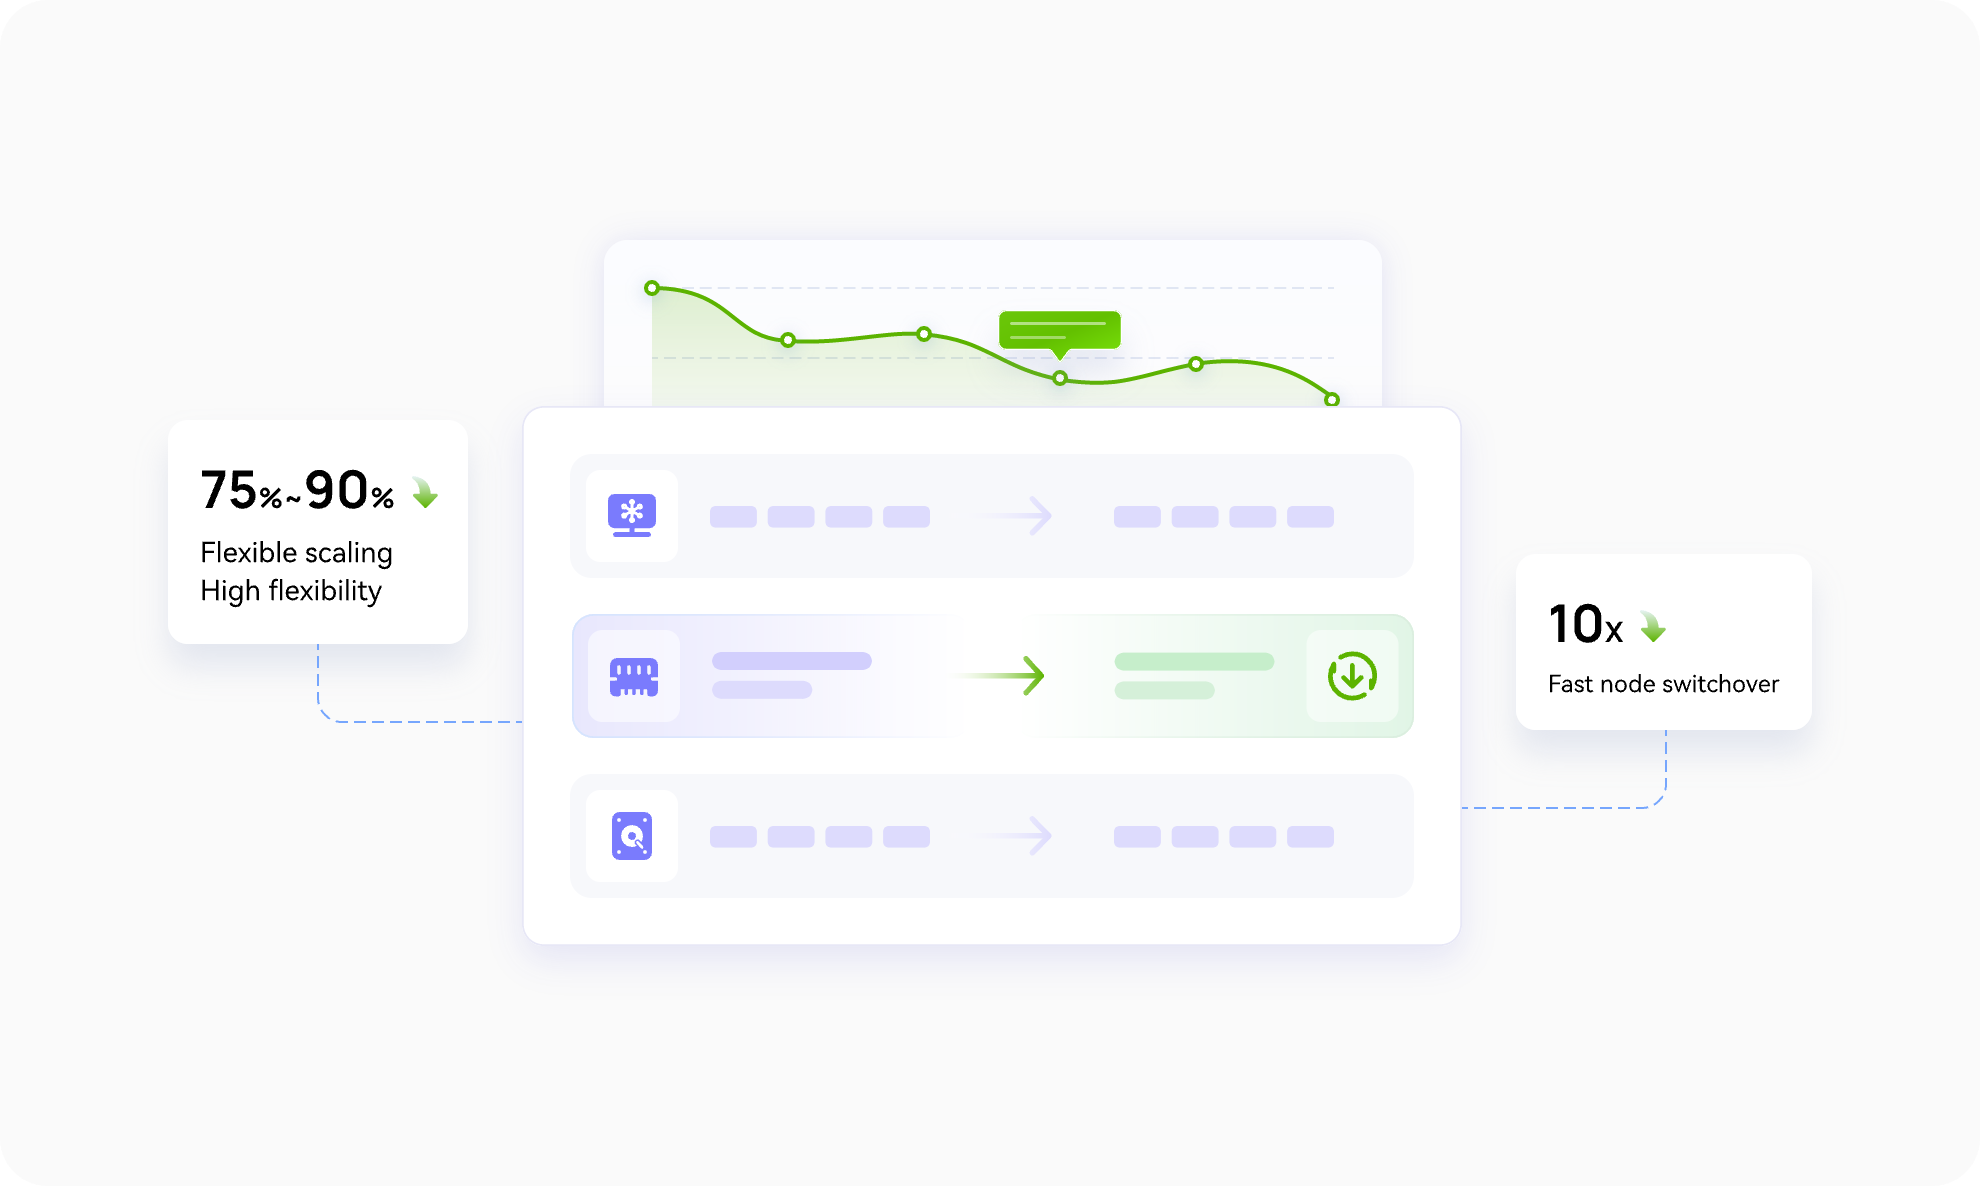
Bajo coste de memoria: GeminiDB Redis API tiene menos requerimientos de memoria que Redis de código abierto, lo que reduce los costes de hardware entre un 75 % y un 90 %.

Bajo coste de almacenamiento: En el caso de datos de series temporales, gracias a la compatibilidad con la compresión adaptativa y el almacenamiento automatizado por niveles de datos de mucho y poco uso, con GeminiDB Influx API deberá pagar solo 1/10 del coste de almacenamiento de una base de datos relacional.
Rentabilidad
Escalabilidad Escalabilidad Escalabilidad
Fiabilidad Fiabilidad Fiabilidad
Rentabilidad Rentabilidad Rentabilidad

Soluciones integrales

Automotriz
tab背景图 tab背景图 tab背景图
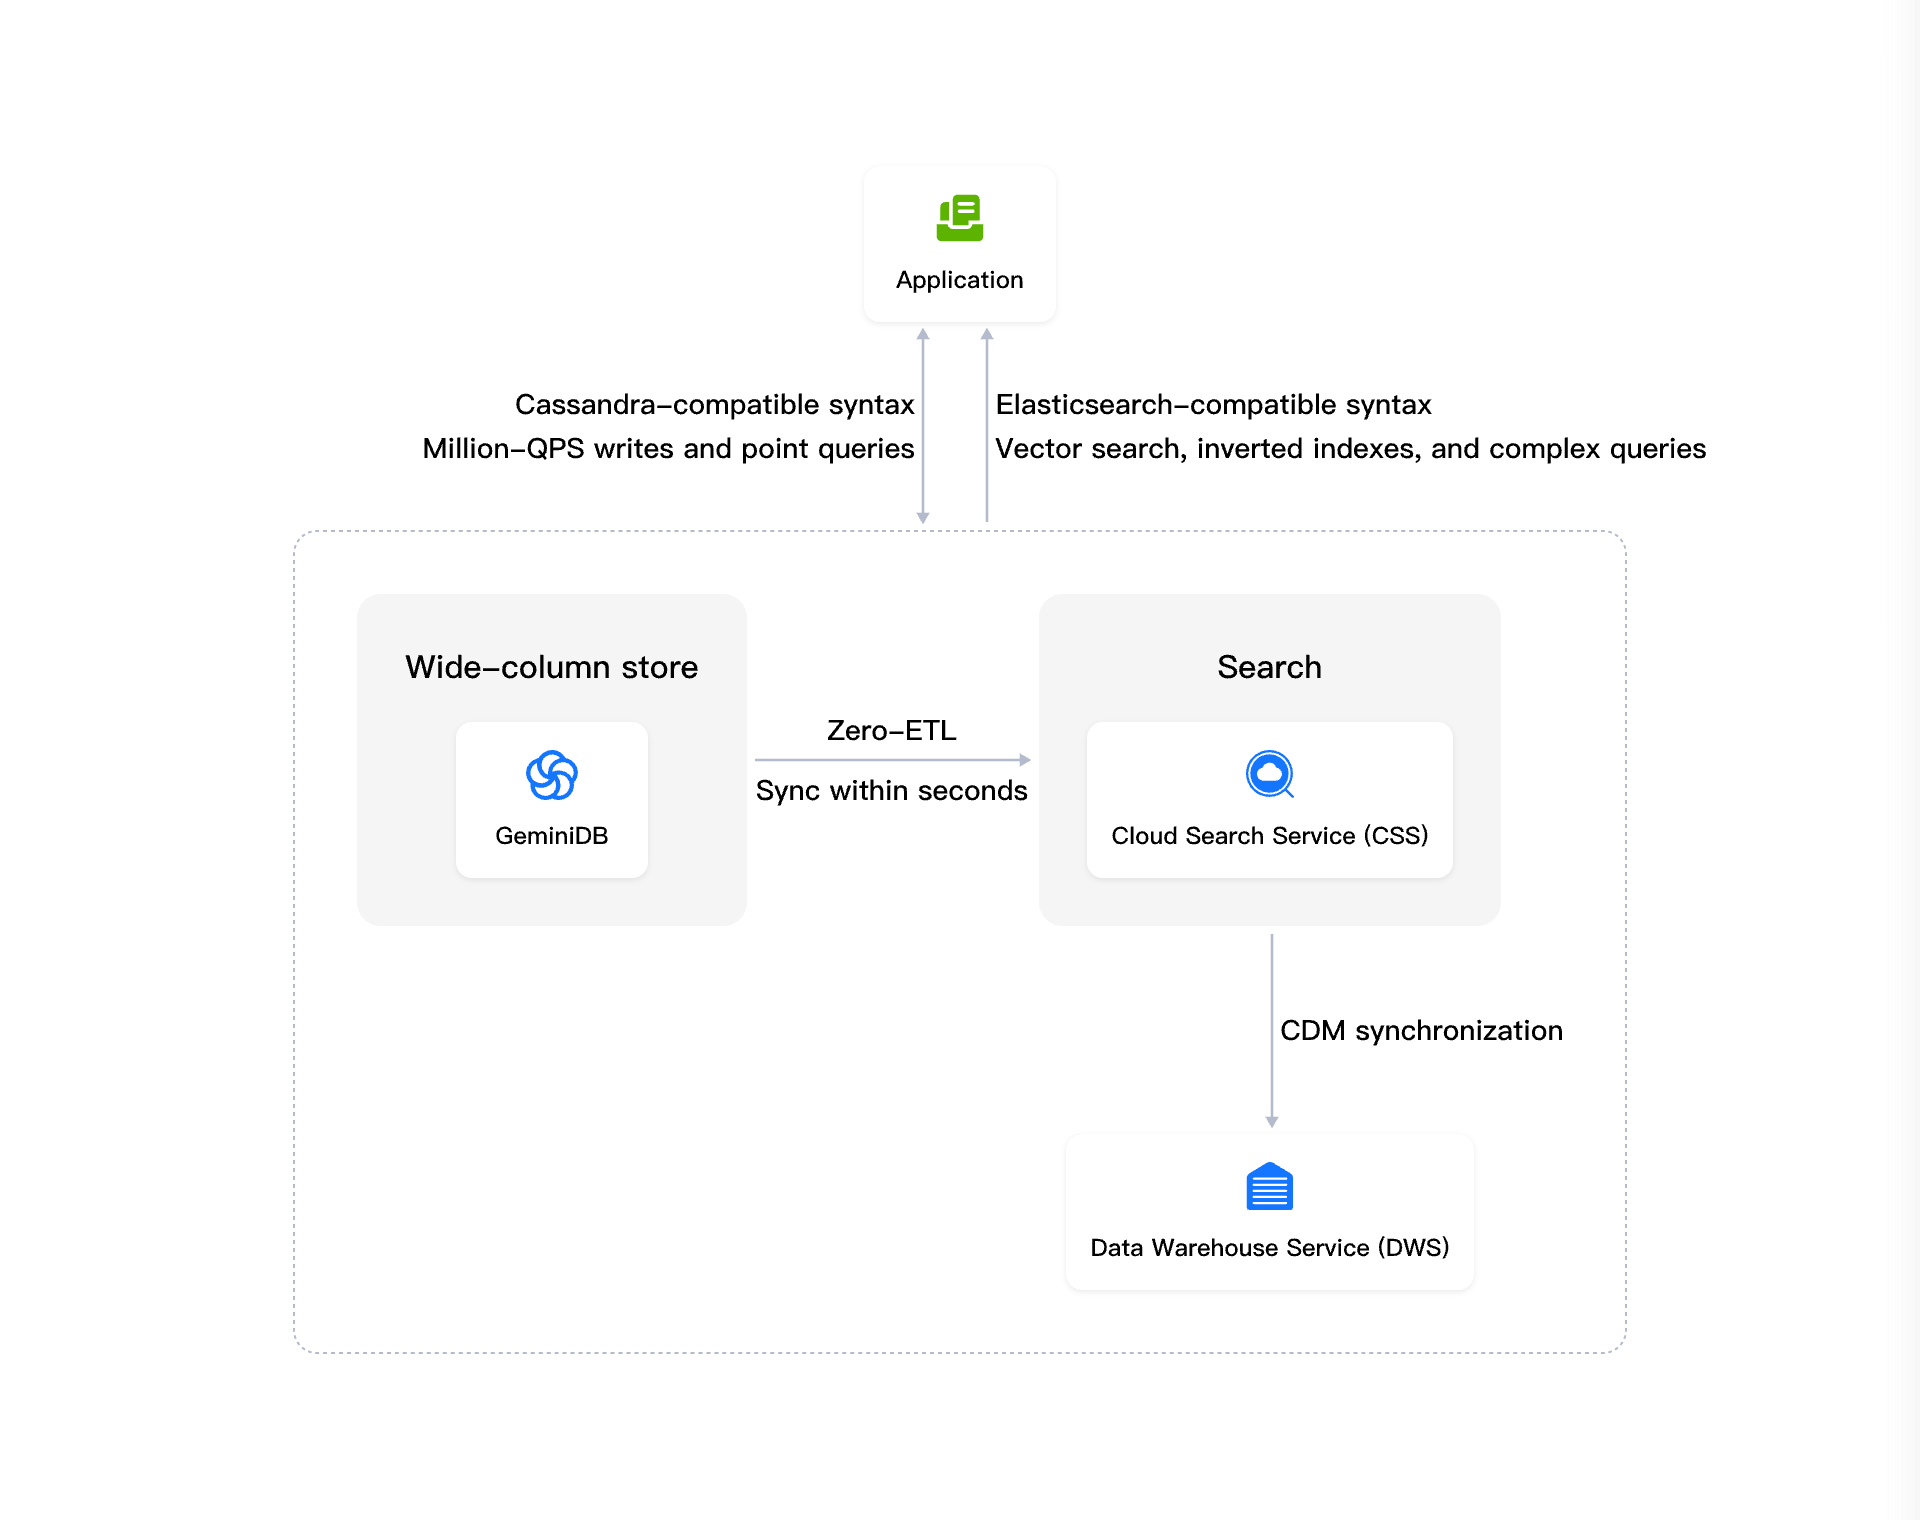
Búsqueda de vectores sin ETL para la gestión de datos de conducción inteligente

La gestión de datos de entrenamiento para la conducción inteligente requiere la ingesta con alta concurrencia de conjuntos de datos multimodales masivos, al tiempo que admite consultas complejas, tales como búsquedas precisas por clave primaria, búsqueda de texto completo, coincidencia aproximada y búsqueda de vectores.

Ventajas
Alto rendimiento

Una arquitectura distribuida sin líder, combinada con escrituras secuenciales basadas en árboles LSM, elimina los cuellos de botella de E/S aleatorias, lo que permite la ingesta de datos de alta concurrencia a escala masiva, al tiempo que se mantiene una latencia de consulta del orden de milisegundos.

Almacenamiento de datos a escala masiva

GeminiDB proporciona almacenamiento persistente fiable para cientos de terabytes de datos, con escalamiento automático de datos de mucho y poco acceso durante todo el ciclo de vida de los datos. Los datos de poco acceso históricos se migran automáticamente a medios de almacenamiento de menor coste, lo que reduce los costes de almacenamiento y O&M a gran escala.

Integración sin interrupciones de búsquedas de vectores

Los conjuntos de datos completos e incrementales se sincronizan directamente con el motor de búsqueda de vectores, lo que permite realizar búsquedas integradas de texto completo y vectoriales sin necesidad de complejos procesos ETL. Las operaciones de extremo a extremo basadas en GUI en la consola mejoran la eficiencia del desarrollo y del O&M en un 30 %.

IA
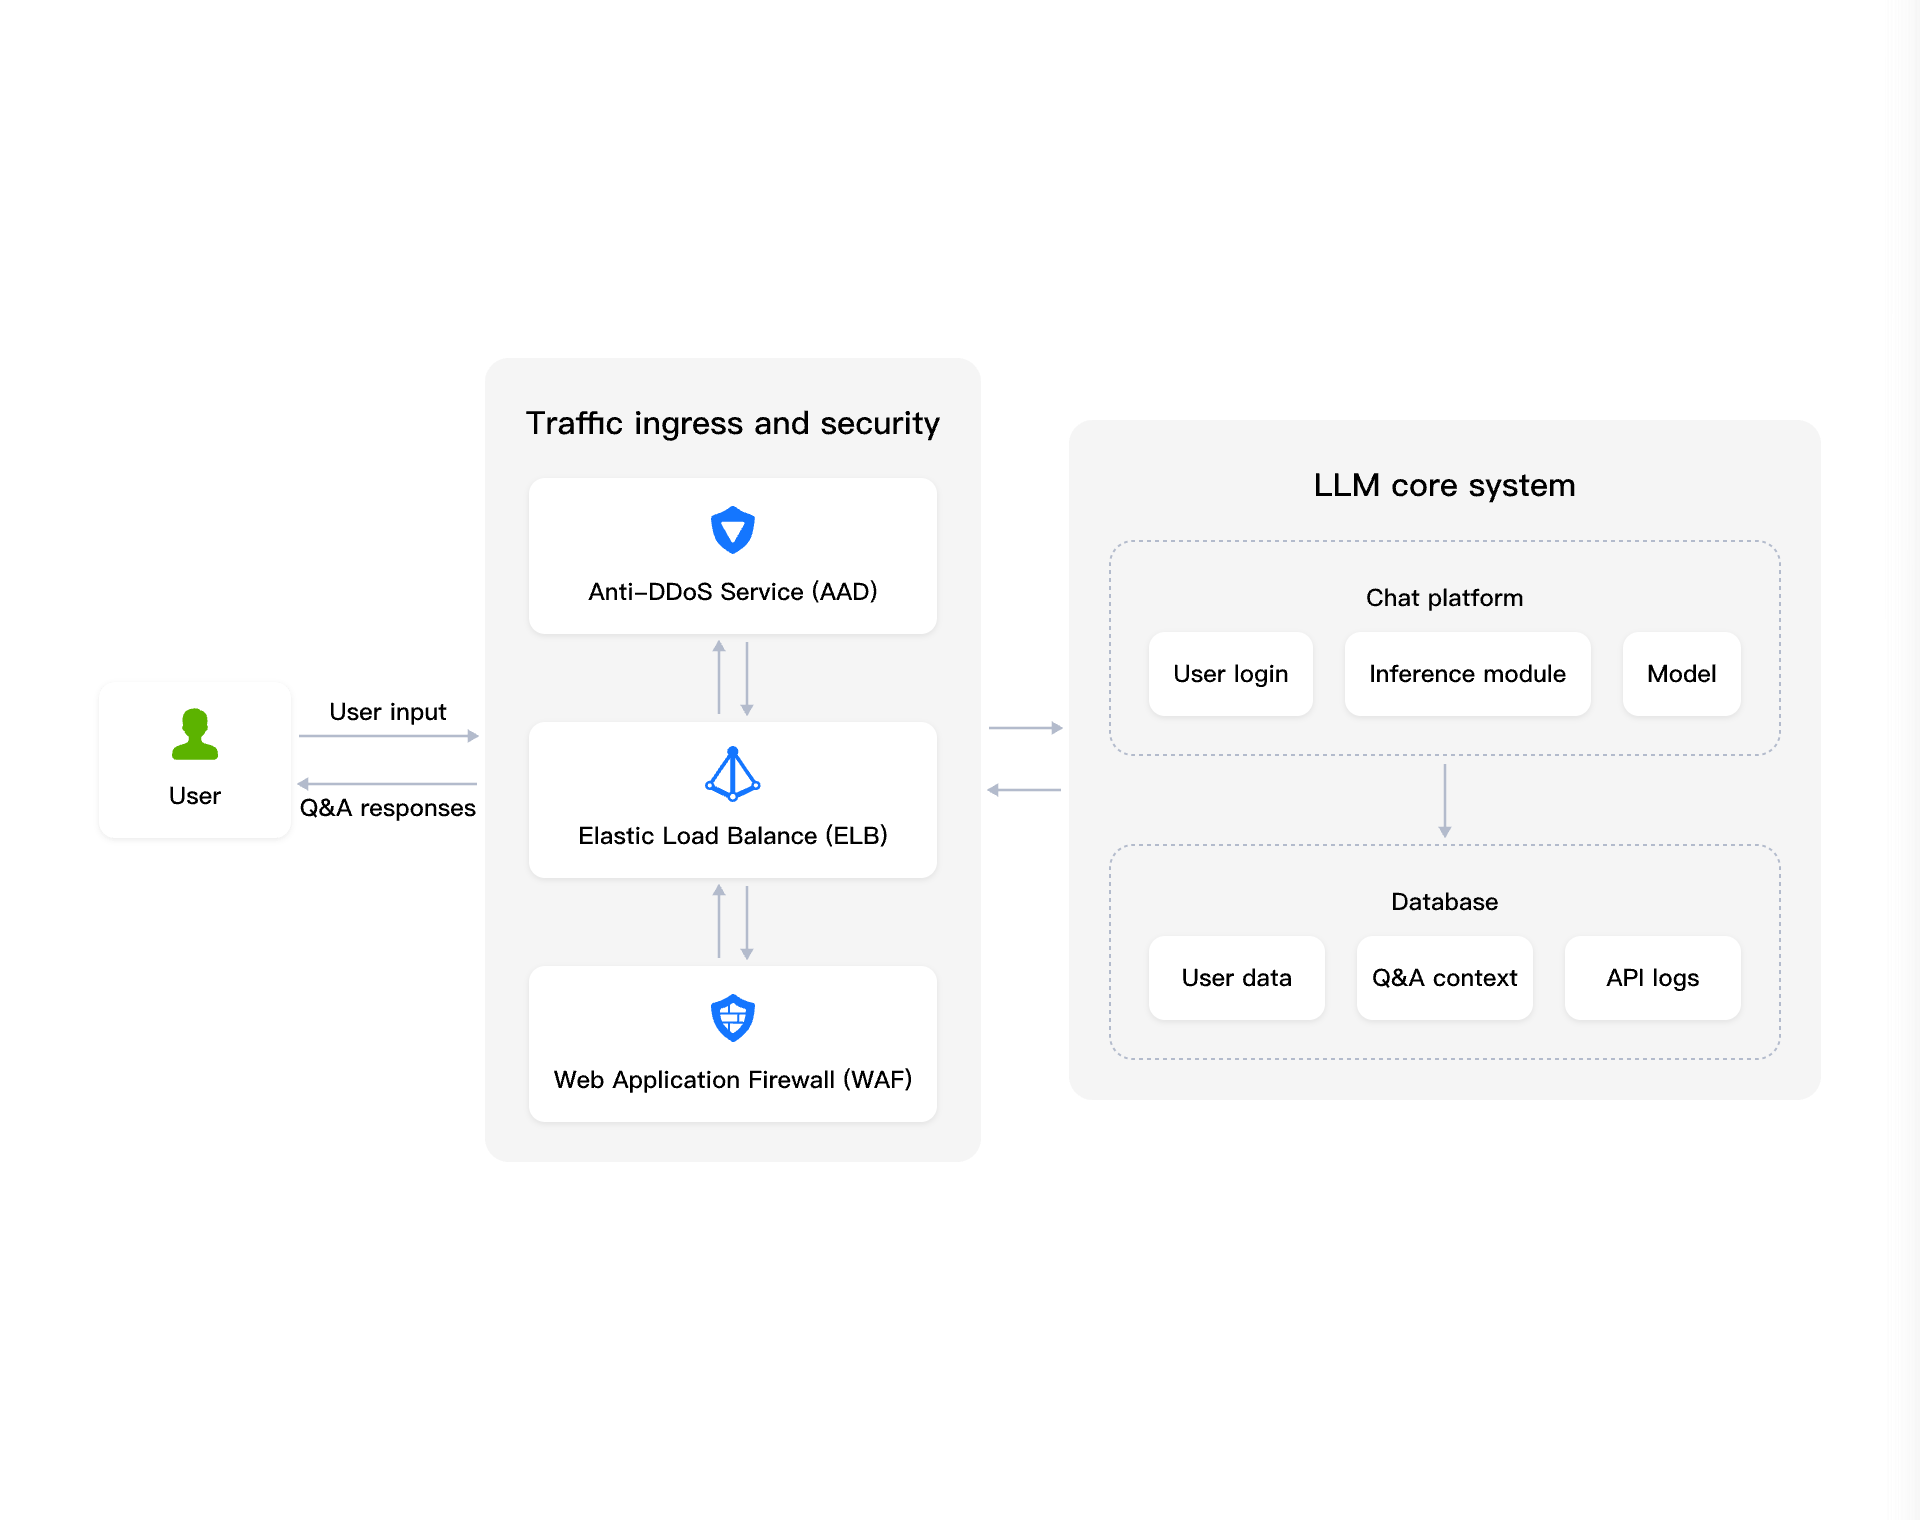
Escalamiento elástico, latencia ultrabaja y alta Fiabilidad para preguntas y respuestas con IA

Las aplicaciones de inteligencia artificial deben gestionar grandes volúmenes de contexto de conversaciones en tiempo real, conversaciones históricas y datos de perfiles de usuarios, al tiempo que mantienen tiempos de respuesta del orden de milisegundos durante los aumentos repentinos de tráfico y equilibran la durabilidad de los datos con los costes de almacenamiento.

Ventajas
Alto rendimiento

La clasificación automática de datos en niveles (mucho acceso/poco acceso) mantiene los datos activos en la memoria, al tiempo que almacena el conjunto de datos completo en un grupo de almacenamiento de alto rendimiento, lo que ofrece una latencia de milisegundos para interacciones de alta frecuencia.

Capacidad masiva, costes minimizados

Una arquitectura de almacenamiento de múltiples niveles que abarca memoria, SSD y almacenamiento de objetos, escala sin problemas hasta cientos de terabytes de capacidad, lo que reduce significativamente los costes de almacenamiento y O&M.

Escalamiento elástico nativo de la nube

Basado en una arquitectura distribuida con almacenamiento y cómputo desacoplados, el sistema puede escalar nodos de cómputo en minutos y el almacenamiento en segundos sin interrumpir los servicios.

Recomendaciones publicitarias
Almacenamiento masivo y alto rendimiento de concurrencia para recomendaciones publicitarias

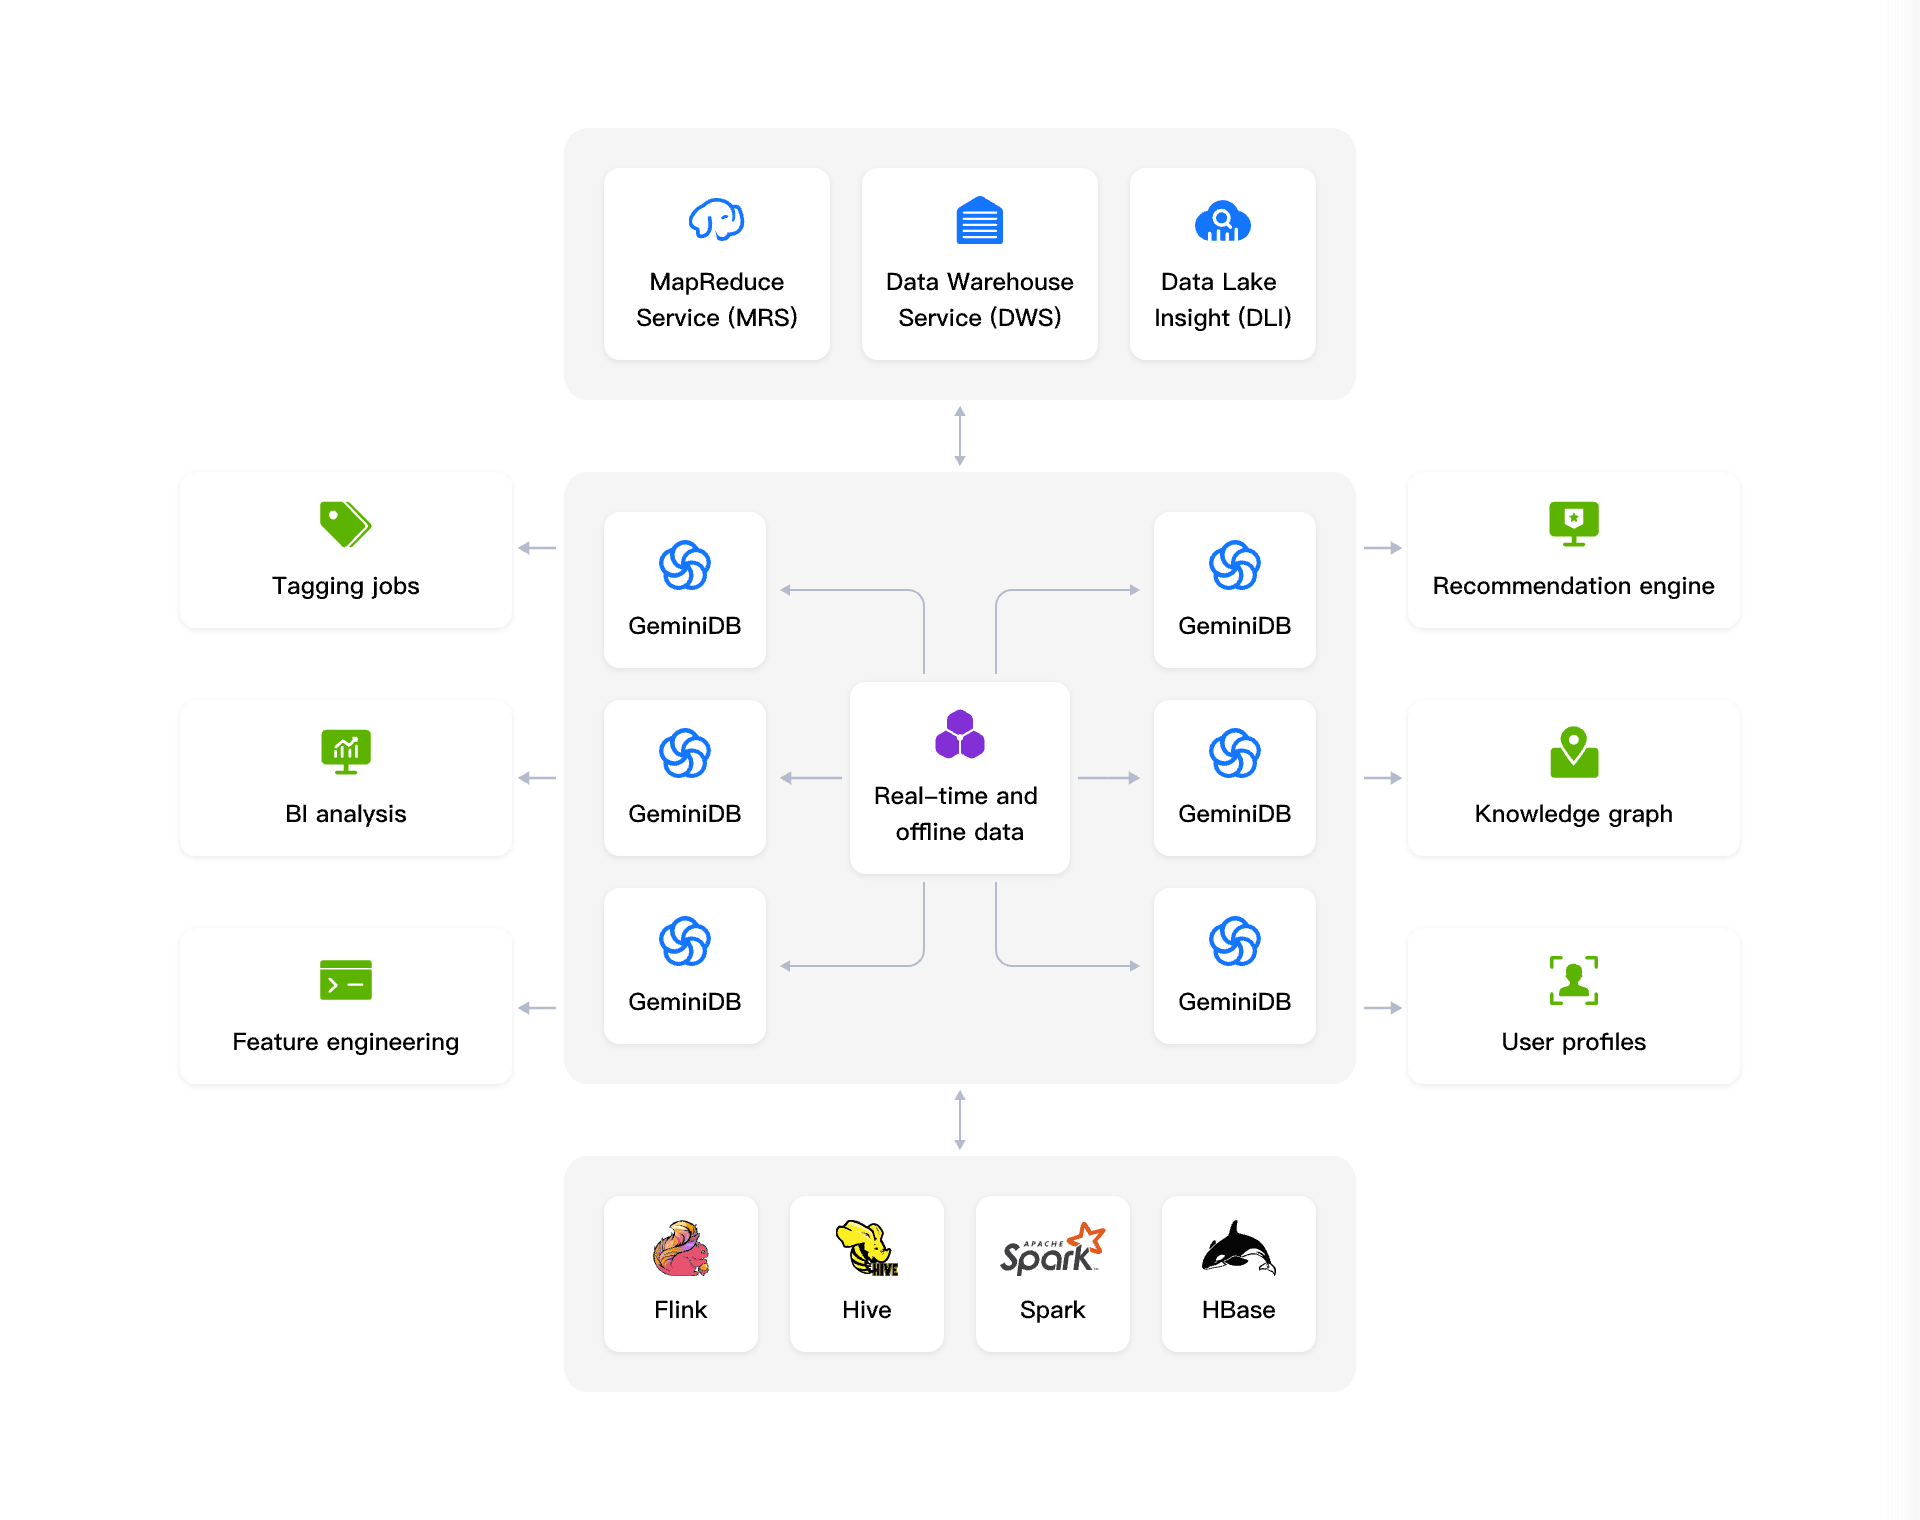
GeminiDB supera las limitaciones de Redis de código abierto tradicional en escenarios de almacenamiento en caché exclusivamente en memoria, gracias a su compatibilidad nativa con un almacenamiento persistente de gran capacidad, altamente fiable y rentable. Está diseñado para cargas de trabajo fundamentales en todo el proceso de datos de principio a fin, incluyendo la creación de perfiles precisos de usuarios, el etiquetado de alta dimensión y la ingeniería de características.

Ventajas
Alto rendimiento

GeminiDB combina una arquitectura simétrica avanzada, en la que todos los nodos admiten operaciones de lectura y escritura, con un motor de procesamiento paralelo de múltiples subprocesos para permitir la ingesta a alta velocidad de conjuntos de datos masivos de características. Ofrece un rendimiento de ingesta de datos hasta 5 veces superior al de Redis de código abierto, y admite lecturas en tiempo real con millones de consultas por segundo (QPS) y una latencia de milisegundos.

Estructura de niveles inteligente para una máxima eficiencia de costos

Para satisfacer las necesidades de almacenamiento de los enormes volúmenes de datos históricos utilizados para el etiquetado y la ingeniería de características, GeminiDB combina el almacenamiento y el cómputo desacoplados con una estructura de almacenamiento de múltiples niveles. El conjunto de datos completo se almacena de forma persistente con alta fiabilidad, mientras que solo los datos de uso frecuente permanecen en la memoria, lo que reduce significativamente los costes de almacenamiento en comparación con las soluciones tradicionales totalmente en memoria.

Alta fiabilidad

GeminiDB ofrece persistencia en tiempo real y altamente consistente, con redundancia de datos de tres réplicas. En caso de un fallo de hardware, el clúster puede realizar una conmutación por error automática y asumir las cargas de trabajo de cómputo en segundos, lo que permite garantizar el funcionamiento continuo de los servicios de pujas publicitarias.

Videojuegos
Infraestructura de datos robusta para el desarrollo ágil de videojuegos

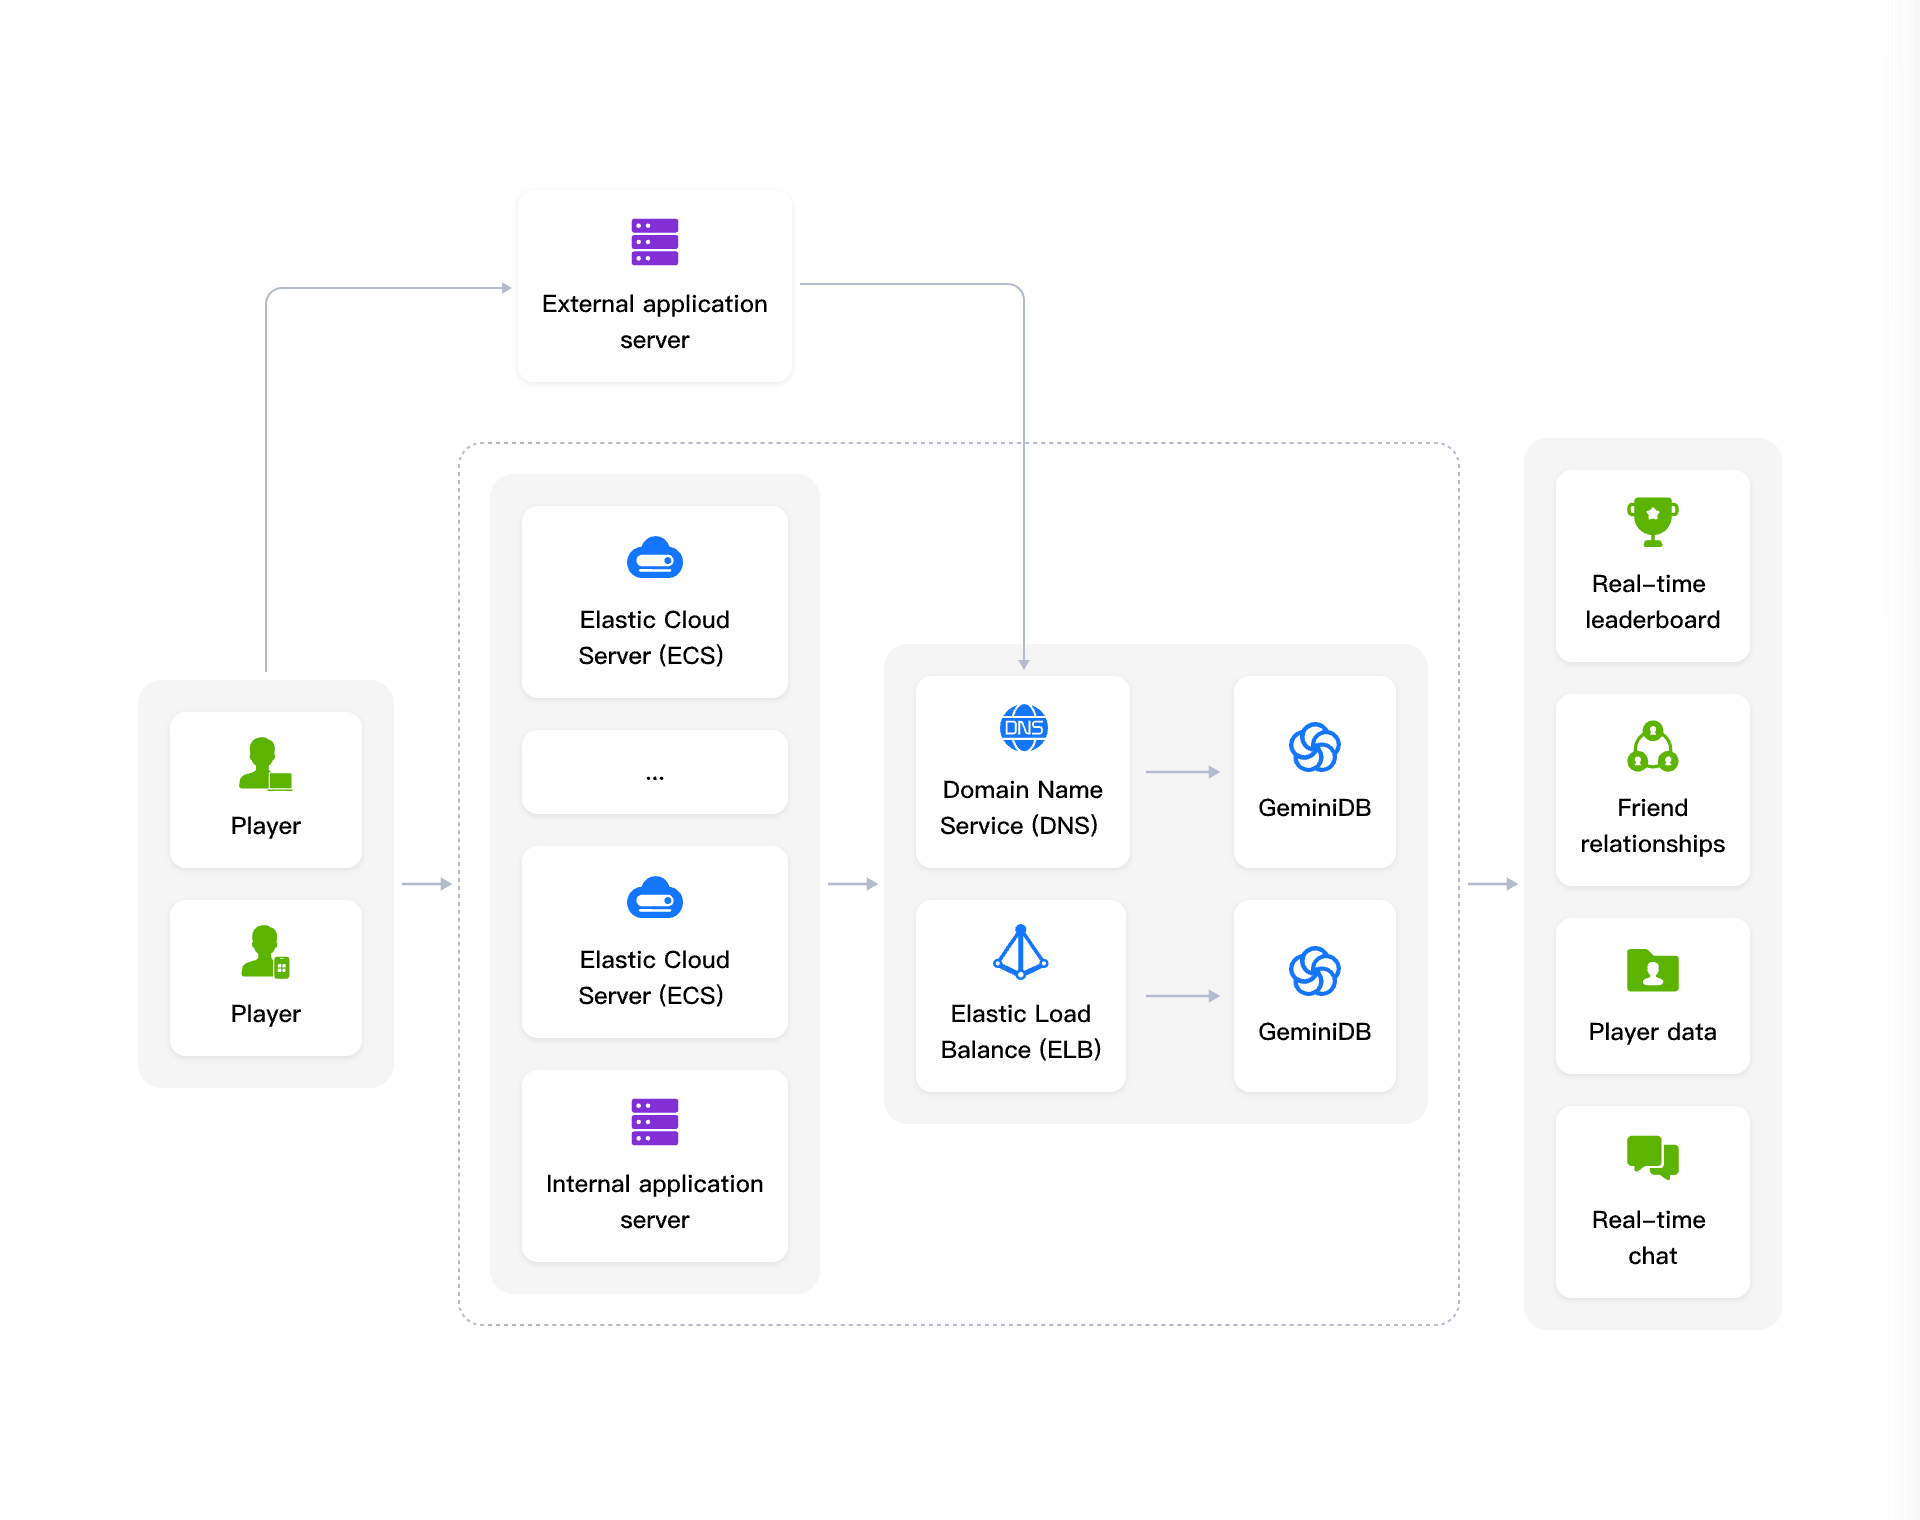
GeminiDB proporciona una API compatible con Redis, con soporte nativo para una amplia gama de estructuras de datos, lo que le permite crear de manera eficiente los sistemas centrales de sus videojuegos. Los Sorted Sets (conjuntos ordenados) permiten actualizar las tablas de clasificación en tiempo real para un gran número de jugadores, mientras que Pub/Sub permite chats en tiempo real de baja latencia y alta concurrencia. GeminiDB es ideal para servidores de backend que gestionan flujos de actividad de los jugadores, cuentas y sistemas de amigos, ya que gestiona de manera eficiente y almacena de forma persistente los datos de actividad de los jugadores, los metadatos básicos de las cuentas y los grafos sociales grandes y complejos.

Ventajas
Amplio soporte de estructuras de datos

El soporte nativo para Hash, List, Sorted Sets y otras estructuras de datos básicas proporciona las primitivas de datos necesarias para la lógica compleja de los juegos, lo que acelera significativamente el desarrollo y la eficiencia de las iteraciones.

Escalamiento rápido ante aumentos repentinos de tráfico

Diseñada para gestionar los aumentos repentinos de concurrencia típicos de las cargas de trabajo de videojuegos, GeminiDB permite un escalamiento vertical del almacenamiento sin interrupciones en segundos y un escalamiento horizontal fluido de los nodos de cómputo en minutos, lo que ayuda a mantener una experiencia de respuesta rápida para los jugadores y servicios básicos ininterrumpidos durante las horas de mayor tráfico.

Almacenamiento de gran capacidad y bajo coste

GeminiDB adopta una arquitectura de almacenamiento y cómputo desacoplados, combinados con un grupo de almacenamiento persistente de alto rendimiento, para ofrecer cientos de terabytes de almacenamiento. La organización inteligente de datos en niveles (mucho acceso/poco acceso) mantiene los datos activos en la memoria y traslada los datos de poco acceso al grupo de almacenamiento, lo que reduce significativamente los costes de almacenamiento en comparación con las soluciones tradicionales íntegramente en memoria, y ofrece un almacenamiento rentable para volúmenes masivos de datos de activos y equipamiento de jugadores.

IoT
Ingesta de series temporales de alta concurrencia para IoT a gran escala

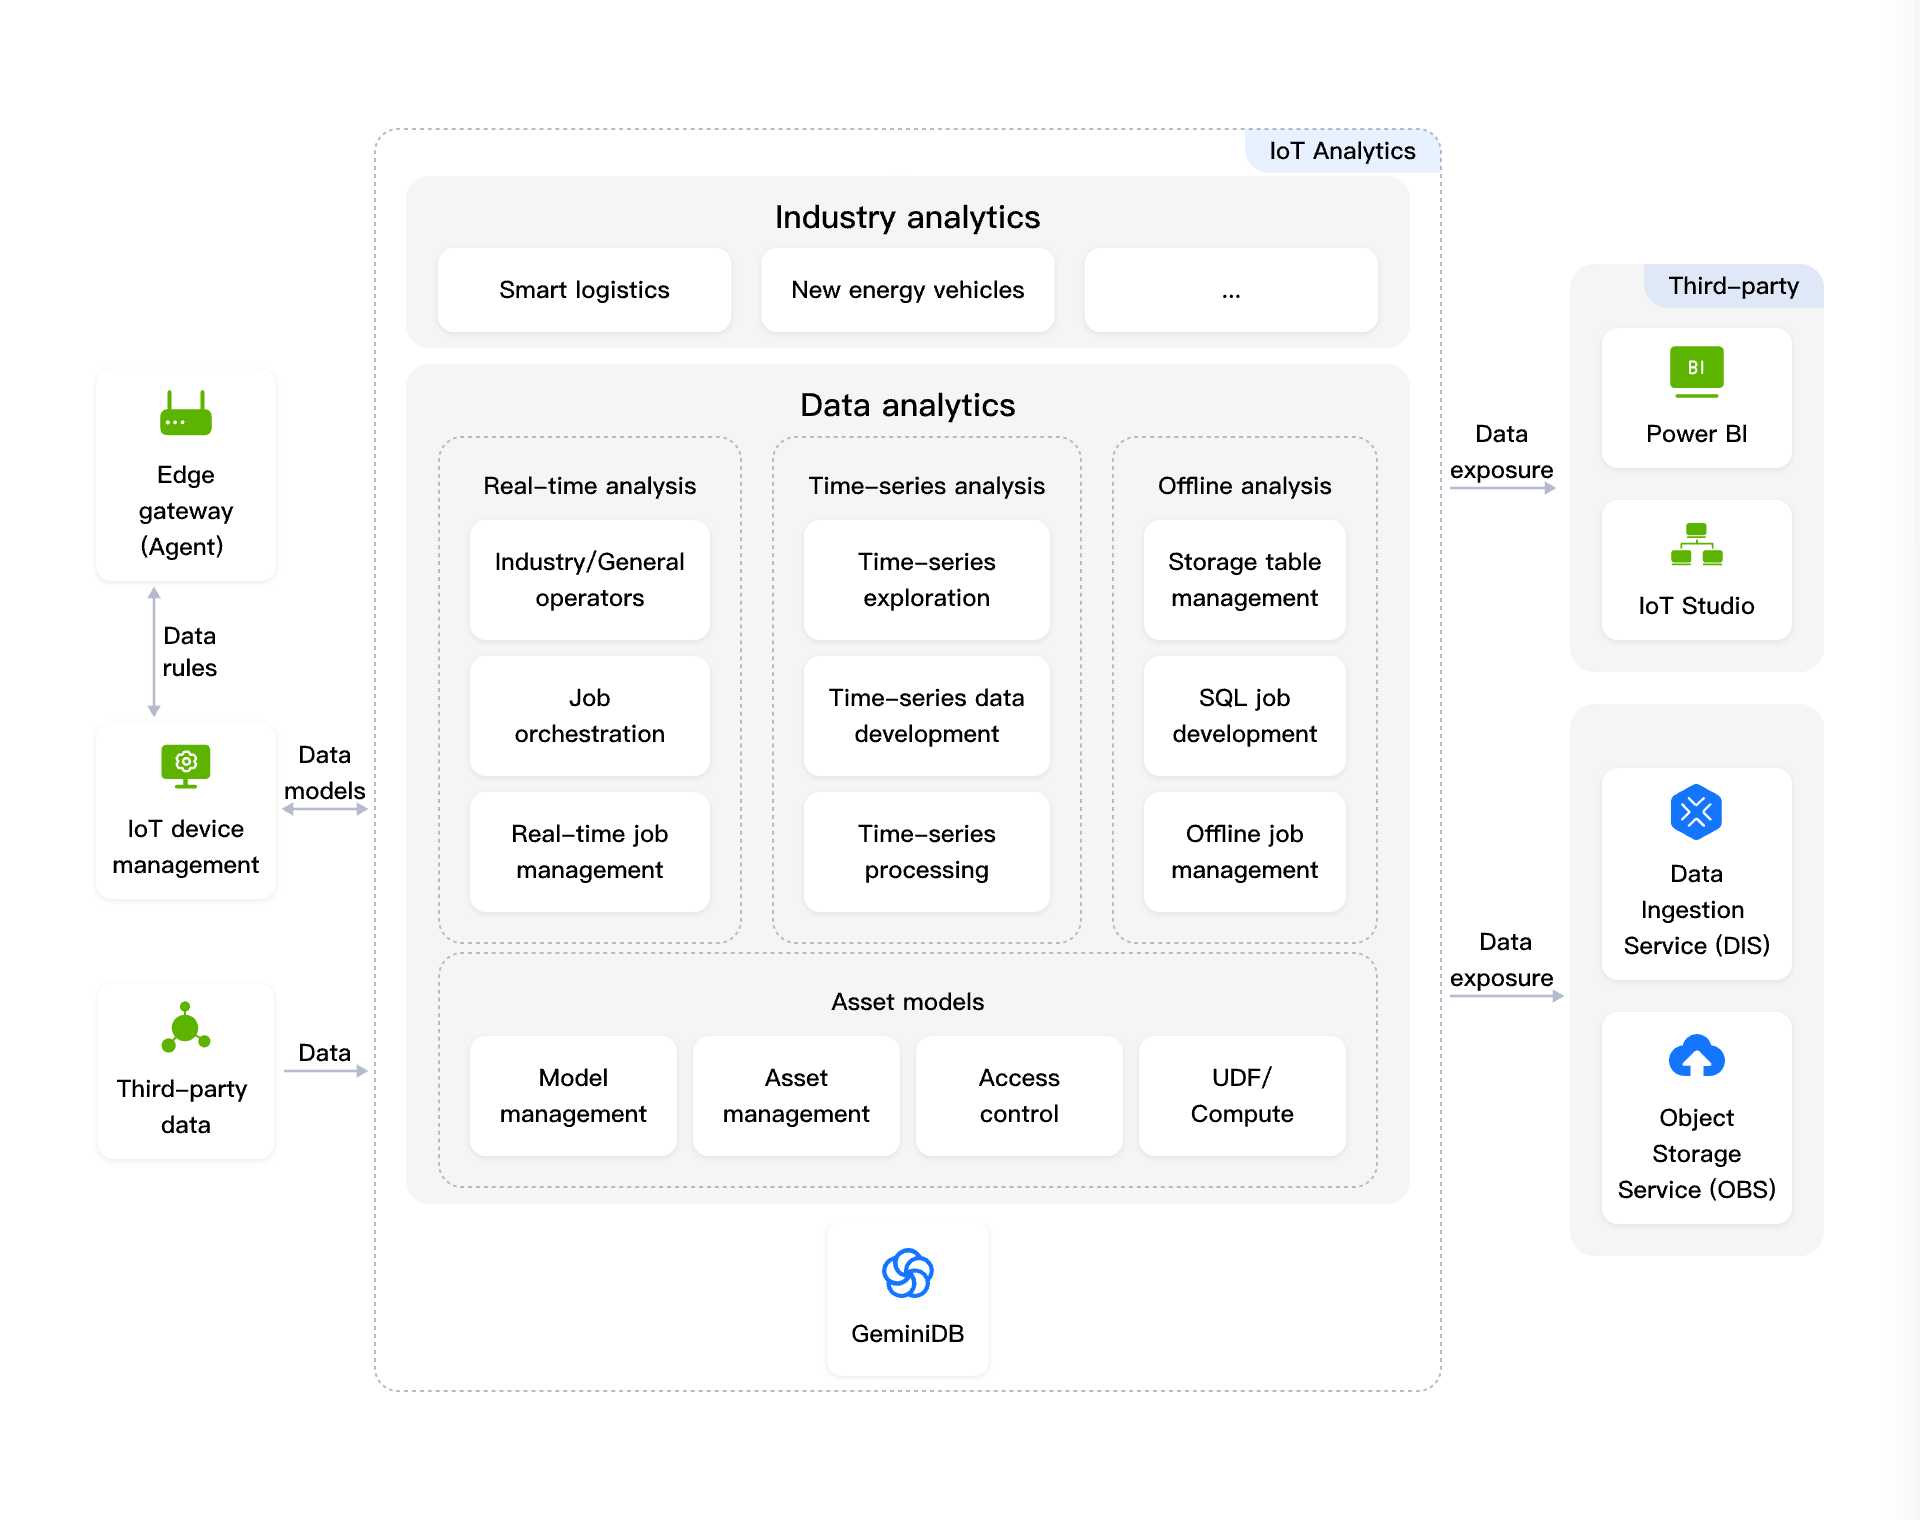
Diseñado para escenarios de IoT industrial y de consumo, como vehículos conectados, ciudades inteligentes, monitoreo meteorológico y dispositivos wearable inteligentes, GeminiDB ofrece una ingesta en tiempo real de alta concurrencia y almacenamiento persistente durante el ciclo de vida completo para volúmenes masivos de datos de sensores multidimensionales de alta frecuencia.

Ventajas
Alto throughput de escritura

Diseñado específicamente para cargas de trabajo de series temporales, GeminiDB ofrece un rendimiento de escritura en lotes pequeños 4,5 veces mayor y un rendimiento de escritura en lotes grandes 3,3 veces mayor que el de InfluxDB de código abierto; además, gestiona con facilidad los aumentos de ingestión de alta concurrencia provenientes de flotas masivas de dispositivos IoT.

Clasificación inteligente de datos de mucho/poco acceso para lograr el máximo ahorro de costes

Los datos de poco acceso se archivan automáticamente en medios de almacenamiento de menor coste, lo que reduce los costes de almacenamiento hasta en un 90 %. El acceso a los datos de mucho y poco acceso se realiza de la misma manera, sin que sea necesario realizar cambios ni adaptaciones en el código de la aplicación. El umbral de edad de datos de mucho/poco acceso también se puede definir de manera flexible y ajustar dinámicamente en función de los requerimientos comerciales.

Exportación automatizada de lagos de datos

Los mecanismos integrados de conversión y transferencia de datos, de gran eficiencia, convierten automáticamente los datos de series temporales en línea a archivos Parquet estándar y los exportan a un almacenamiento de objetos, donde pueden servir como fuente de entrada principal para los motores de procesamiento de big data. Esto permite una exploración más profunda y un análisis complejo de conjuntos de datos masivos.

Innovación continua con millones de clientes
Innovación continua con millones de clientes

Travelgate acelera la distribución hotelera global con GeminiDB de Huawei Cloud
GeminiDB impulsa la interacción inmersiva en tiempo real para cientos de millones de usuarios de Mini World
GeminiDB ayuda a MeetYou a mejorar los servicios de salud de las mujeres
Travelgate acelera la distribución hotelera global con GeminiDB de Huawei Cloud

Travelgate acelera la distribución hotelera global con GeminiDB de Huawei Cloud

Travelgate migró la base de datos principal que respalda Speed-X de su base de datos heredada a GeminiDB de Huawei Cloud. La migración mejoró el rendimiento en los escenarios principales de Speed-X en un 50 %, lo que permitió que Speed-X siguiera funcionando de manera fiable incluso cuando el tráfico empresarial se quintuplicó con respecto a la escala original. Además, la eficiencia de O&M y desarrollo mejoró significativamente.

GeminiDB impulsa la interacción inmersiva en tiempo real para cientos de millones de usuarios de Mini World

GeminiDB impulsa la interacción inmersiva en tiempo real para cientos de millones de usuarios de Mini World

Con GeminiDB, Mini World logró la sincronización y actualización de datos a escala de TB entre múltiples regiones, redujo los costos generales en un 60% en comparación con Redis de código abierto y triplicó la capacidad de datos de los perfiles de usuario. Impulsado por un grupo de almacenamiento distribuido de alto rendimiento, GeminiDB ofrece acceso en milisegundos a los datos de chat en tiempo real para decenas de millones de jugadores, lo que permite interacciones inmersivas para cientos de millones de usuarios.

GeminiDB ayuda a MeetYou a mejorar los servicios de salud de las mujeres

GeminiDB ayuda a MeetYou a mejorar los servicios de salud de las mujeres

GeminiDB permite a MeetYou lograr una gestión automatizada de fallas, un monitoreo por segundos y una O&M inteligente. El escalamiento elástico de recursos redujo los costos en un 20 %, lo que ayuda a MeetYou a atender de manera fiable a más de 300 millones de usuarios.
Recursos

Recursos